LLM-based multi-agent systems for clinical workflows: a survey of AI hospitals
论文框架
论文提出了人工智能医院(AI hospital)的概念:
人工智能医院指工作流程级的多智能体临床模拟或部署,具有明确的角色、跨交接的共享状态、基于证据的工具、安全门和纵向跟踪。这是”像医院一样运转”的最低条件。一个系统可以只做会诊、分诊、出院、医学教育或心理健康随访,但只有当它的行动被组织为”跨角色、跨阶段、有持久上下文、有明确问责、有可审计日志”的流程时,才算进入 AI hospital 的范围。
| 步骤 | 干什么 |
|---|---|
| Triage(分诊) | 判断紧急程度,收集第一份结构化信号,例如急危重症等级、红旗警示、初步证据链接 |
| Consult(会诊) | 更新初步诊断,把证据链接到建议的行动,并明确还需要澄清什么 |
| Discharge(出院) | 把当前方案转化成患者指导、随访计划和升级标准 |
不同于医疗保健聊天机器人,这里的重点是明确的状态和切换、操作感知评估,以及作为分阶段协议而不是松散声明的部署准备情况。
普通的医疗保健机器人
- 关注”模型能不能答对问题”;
- 每个回答、每轮对话基本独立,答完就算完;
- 评测以最终答案的准确率、F1、人工评分为主;
- 说”可以部署”往往只靠一个 benchmark 分数,算是一个”松散声明”(loose claim)。
AI hospital
- 病例不是”问一句答一句”,而是有持久状态:分诊产生急危重等级,会诊更新初步诊断并附上证据,出院把方案转成随访计划;
- 不只看最终诊断准不准,还看过程与运营指标:交接完整性、证据覆盖率、升级是否及时、该阻止而没阻止、延迟、人工介入次数、日志能否回放;
- 论文不承认”benchmark 高 = 能部署”,而是给出 IRL1–IRL6 的分级协议:先在模拟环境(IRL1–2),再到真实数据影子回放、人机共决试点(IRL3–4),最后才限范围上线、多中心铺开(IRL5–6);每一级晋升都必须提供指定证据,比如回放证据链、升级召回率、零 PHI 泄露、漂移监控等,达不到就卡在那一级。
系统设计规范
角色和交接
第一个设计决策是:工作流程是否真正需要多个角色。单个代理可能足以完成狭窄的、低风险的步骤,再加上强有力的人工审查。当案例跨越护理阶段、专业或批准边界时,多代理结构就有用了:所有权会变化,下一个角色必须继承明确的状态,而不是去猜。
- 面向患者的角色:决定哪些信息进入工作流程。价值不只是多几个专业人员,而是能明确责任归属、把专业领域的预设前提摆到明面上,并在工作流程继续推进之前化解分歧。
- 规划和编排角色:把案例分解为多个步骤,确定还缺哪些信息,并对案例进行接待、分类、咨询或后续处理。当系统必须协调多个本地决策时,比如分诊输出决定咨询代理下一步问什么、或哪个服务接收患者,这些角色非常有用。
- 评判、批评和记录角色:当工作流程需要明确的协调、指南检查或可审计的摘要,而不是一轮自由形式的讨论时,法官、评论家、决策和记录角色就有用了。实践中,多智能体开销主要在这些责任函数可测量时才合理,而不只是当模型能生成更多推理分支时。
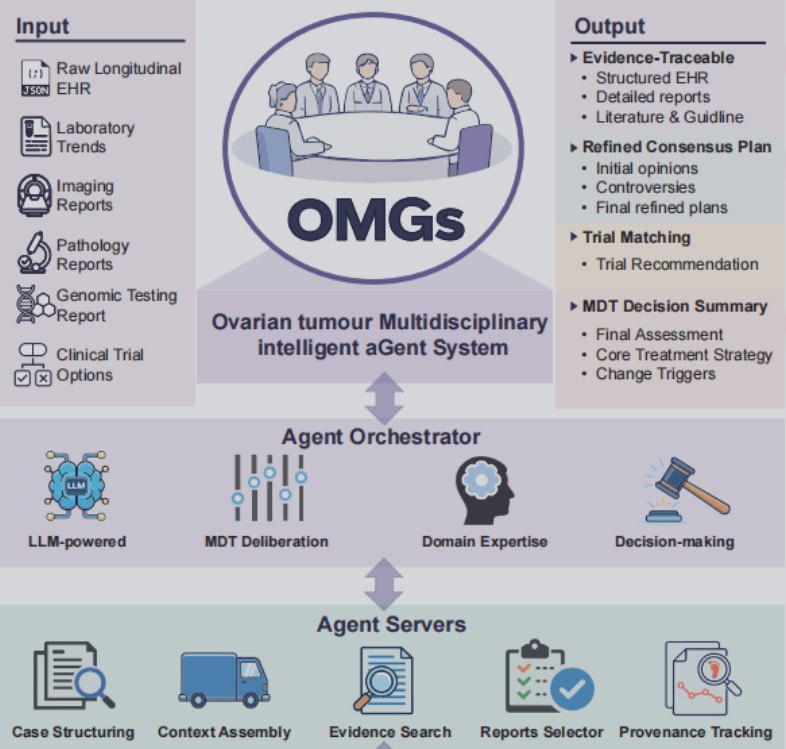
⭐ 在这一步我们要有一个大概的设计,即这个病例应该有几个agent负责?
记忆、证据和工具
第二项设计考量是,确定角色交接完成后,下一岗位需要获取哪些信息。完成分诊之后,接手的咨询处理人员不应该再去揣测病情危急程度信号、现存问题、已开具的检查项目,以及当前诊疗方案背后的依据。下面的设计思想让实例可以恢复、证据可以归属:
- 长期记忆和证据来源(Long-term memory and evidence sources.):设计问题不只是”知识存在哪里”,还有如何恢复每个支持项、给它们做版本控制、并把它们和后续操作联系起来。
- 工作记忆和切换恢复(Working memory and handoff recovery.):工作记忆携带跨角色的活动案例状态。实际中就是摘要、中间决策、证据 ID、悬而未决的问题和升级标记,让新代理可以恢复工作流程,而无需从头重建。
- 执行和验证工具(Execution and verification tools.):它们把”计划该不该通过”变成可以在流程里执行的检查,并且能记录”过了没有、依据是什么、是谁执行、用的哪个版本的指南”,相当于多智能体系统里的”安检门”。
- 临床决策树、计算器:对分诊、剂量、禁忌证做显式的指南检查,比如”这个剂量是否超指南上限”;
- 虚拟 EHR 工具:在受控环境里模拟读写电子病历,暴露证据来源和阶段性失败;
- LLM-as-KB 式工具:用 LLM 当知识库做灵活综合,但一旦进入工作流,必须带显式溯源(provenance)。
- 多模式和研究工具(Multimodal and research tools.):它们不是”提高一点准确率的插件”,而是把证据和行动变成可审计的工作流对象——每次工具调用都要留下日志、来源、版本,以后能回放、能追责。
- 多模态工具:把影像、病理切片、传感器等非文本证据和后续推理绑定,确保诊断结论确实锚定在”系统看到了什么”上,比如影像报告必须有 image-to-report 链接、图片 ID、预处理版本;
- 研究工具:执行代码、结构化分析、研究自动化,比如跑数据分析脚本、做统计计算,主要用于科研工作流,强调过程可复现。
⭐ 在这一步我们应该把agent的权威性树立起来
证据访问工具负责”找到依据”;
执行/验证工具负责”这一步能不能过、能不能执行”;(不是泛泛的”能不能执行医学决策”,而是”这步决策能不能通过显式规则检查并留下执行痕迹”)
多模态工具负责”图片/传感器证据没有脱离决策链”;(不是”判断决策是否在医学范畴”,而是”判断决策是否锚定在真实观察到的证据上”)
研究工具负责”科研动作可复现”。
推理、控制和升级
第三个设计决策是控制。重点不在于推理看起来有多复杂,而在于指导行动的政策是什么。在类似医院的工作流程中,系统必须在继续执行、要求缺失证据、放弃、升级之间做决定。因此,有用的可观察结果是遗漏、分歧、弃权、证据覆盖、延迟和回滚行为。
- 直接推理(Direct reasoning.):任务明确、指导面稳定时,单路径推理效果最好。
- 多路径推理(Multi-path reasoning.):工作流程确实存在多方专业视角差异,或还有悬而未决的不确定性时,可以用并行分支、充分研讨或投票机制处理。
- 反馈来源(Feedback sources.):反馈来自临床医生、工具、知识库,或交互中的后续回合。外部反馈通过新证据或专家修正更新计划。
- 控制策略与关卡(Control policies and gates.):一套实用的系统不是一味增强推理,而是提供一个自主权限调节旋钮,界定工作流何时继续执行、何时请求补充缺失依据、何时选择不做判断、何时向上升级处置。
临床直接工作流(工作流的设计)
主要临床工作流类别,差异在于系统处于诊疗路径的哪个环节,以及哪一类故障风险占主导地位。同一架构在某一类工作流下可能表现尚可,换到另一类就会显得脆弱,因为工作流不同,对交接质量、证据关联和升级处置策略的要求也不同。
端到端临床工作流仿真与虚拟病房:这类场景和分诊、会诊、出院这套实际运行案例最贴近。系统必须补全缺失的临床证据,在多轮交互里更新诊断假设,并跨多个角色、多个诊疗阶段保存业务状态。这类方案的核心价值在于阶段级可观测性:不只是对最终输出打分,还能定位证据缺失的位置、交接失效的环节,以及本应触发升级处置的节点。
会诊、多学科协作与复杂决策:当专科特有约束或持续存在的临床不确定性,让单一推理路径容易失效时,这类工作流就显得重要。代表性系统会主动追问补充信息、动态更新鉴别诊断、整合结构化临床证据,或针对罕见复杂病例召集多学科团队会诊。
分诊、患者分流、诊疗交接与出院沟通:这类工作流受业务运行约束影响最大。输入信息噪声多,审批权责边界频繁出现;评判质量的标准是交接信息是否完整、下游环节是否可用,而不是单一诊断结果。面向患者的交接任务(出院告知与随访准备)把这一点体现得最明显:系统必须留存已确定的诊疗结论、已向患者告知的内容,以及仍需升级处置的事项。这类场景里,工作流日志是任务定义的固有组成部分,不是事后附加的产物。
人工智能模型的评估和部署的准备
AI 医院场景下的模型评估,正从孤立的考试式测评,转向交互式患者任务、覆盖多类临床任务的基准套件、虚拟电子病历(virtual-EHR)环境,以及前瞻性预实验研究。针对工作流级系统,评估对象不只是最终输出,还包括各执行步骤与交接环节的行为表现。
我们把上述评估信号整理成四层评估体系:安全层、流程层、结果层、运维层。以「分诊→会诊→出院」这条业务流程举例:
- 安全层:判断危险诊疗建议是否被拦截;
- 流程层:核查每一步是否携带完整业务状态与证据依据;
- 结果层:判断最终处置方案或健康宣教内容是否准确、具备实用价值;
- 运维层:统计该工作流产生的时延、Token 开销以及人力成本。
所以同一次模型运行记录要支持复现回放、审计核查与运行分析,而不是只输出一个最终分数。
从模型能力到工作流可观测指标
在某个场景里,一项模型能力是否有价值,取决于它能不能改变工作流可观测指标、日志采集要求,或可被合理赋予的自主权限等级。只说”推理更好、检索更多、工具用得更勤”不够。有用的声明是:系统现在能安全地做什么、必须记录哪些额外证据,以及哪种更强的自主声明变得合理。
- 改变工作流可观测指标(workflow observable):某个能力让系统在流程里的可测量行为变好了,例如高危步骤不再默默确诊而是正确推迟/升级、会诊输出开始带病历链接的证据、下一个角色拿到的交接更干净、医嘱能带溯源执行。
- 改变日志采集要求(logging obligation):因为这项能力,出现了”必须新增记录什么”的义务,例如要记录理由编码的弃权(reason-coded abstention)、升级精确率/召回率、工具成功/失败、跨模态一致性、工具/指南版本。
- 改变可被合理赋予的自主权限等级(level of autonomy that can be justified):这项能力让系统”有资格”往上走一级自主权限,例如从”人说了算”到”自动建议但高危步骤必须人工批准”,再到”有监督的自主执行”。
论文给的具体例子(Table 2):
| 能力 | 应出现的可观测工作流变化 | 要记录的日志/指标 | 支撑的更强自主声明 |
|---|---|---|---|
| 更好的校准/弃权 | 高危步骤推迟或升级,而不是默默确诊 | 理由编码弃权、升级精确率/召回率、override 结果 | 需要批准的试点/受监控的高危门控 |
| 证据锚定检索 | 会诊/出院输出带病历链接证据而非无引用断言 | 引用覆盖率、证据门通过率、引用与记录一致性 | 可回放证据链的影子评估 |
| 长上下文/纵向状态 | 后续角色拿到更干净的交接、跨就诊可回放 | 交接完整性、回放成功率、跨就诊一致性 | 纵向影子回放、多就诊评估 |
| 可靠的工具/计算器 | 受管制的检查和行动带溯源执行 | 工具成功/失败、指南依从率@步骤、回滚率 | 分诊/医嘱/出院检查的受控使用 |
| 多模态锚定 | 影像类判断链接到真实观察到的证据 | 跨模态一致性、影像到报告链接 | 影像/监控工作流的可审计提交 |
所以这句话可以简单理解成:“模型更厉害”不是结论,只有当它变成”流程里能看见、能记录、能支撑更高自主级别”的变化时,才算有价值。
基准(benchmark)分数高 ≠ 可以部署
基准问的是”在一个设计好的任务里,它能不能表现好”;部署就绪问的是”把回放、升级、运营一起检查之后,它声称的那级自主权还站得住吗”。放在 MDT 里:某 MDT 系统在诊断准确率基准上拿了高分,不等于它能在会诊里安全运行——你还要看它跨专科交接是否完整、遇到分歧有没有正确升级、有没有能回放的证据链和过程/运营日志。
基于IRL的从沙盒环境到正式部署
把部署拆成三个阶段、六个等级(IRL1–IRL6)。IRL 阈值是”协议默认值”,不是普适常量,必须按任务风险、站点政策、基线对照、可接受失败预算来校准;所以它更像”治理模板”,而不是一劳永逸的数字。每个等级规定两件事:允许的最高自主权是什么,以及要晋升到下一级必须先拿出什么证据。
三个阶段:
- Simulation(模拟):IRL1 静态/脚本化沙盒、IRL2 加噪声/缺信息/对抗性模拟。系统只能在沙盒里跑,重点看”不安全输出率、越狱抵抗、引用覆盖率”。
- Replay / Pilot(回放 / 试点):IRL3 在真实数据上影子回放(模型提出、人决定,无实时影响)、IRL4 有限的人机共决试点(低风险步骤可自动建议、高风险步骤必须人工批准)。证据开始要求”可回放证据链、交接完整性、升级召回率、零 PHI 泄露”。
- Rollout(铺开):IRL5 限范围上线、带端到端监控(自动默认 + 例外人工复核)、IRL6 跨站点/多语言规模化(有监督自主 + 定期审计)。要求漂移仪表盘、事件响应、跨站点一致性、ROI。
合成数据用于生成/压力测试用的证据不是部署用的证据
合成数据用于训练和压力测试:生成对话、工作流状态转换、缺信息病例、交互模式——这些在真实数据里往往很难大规模采集。在医疗里能扩大覆盖范围、减少直接隐私暴露。但合成数据有明确局限:合成工作流会扭曲真实分布,prevalence(疾病比例)、coordination patterns(协作模式)、error surfaces(错误面)都可能和现实不一样。所以在沙盒生成的”看似成功”的表现,不能直接外推到真实环境。
“用合成的假病历跑通了一次会诊”根本不等于”这系统能在真实病房上线”;合成数据只是训练和压测的好工具,不能拿来证明部署就绪。
失败的五种模式和路线图
AI hospital 的失败很少只出在单个模块里,而是表现为跨角色、记忆、工具、控制的”工作流级崩溃”。
五种失败模式(Table 5)
| 失败模式 | 是什么 | 最先出现在哪 | 设计应对 |
|---|---|---|---|
| Longitudinal drift(纵向漂移) | 把历史状态和当前状态混在一起、跨次就诊不一致、无法重建”后来的动作为什么由之前的动作推出” | 随访、慢病、心理健康交互 | workflow-aware 记忆 + 可回放的纵向痕迹 |
| Capacity-blind planning(无视容量的规划) | 方案在临床上说得通,却忽略床位、人力、转运延迟、队列负载 | 床位管理、路由、转病房 | 压力测试影子回放、队列感知模拟、TTD/吞吐量/延迟尾部不回归检查 |
| Ungated deviation / weak escalation(无门控越轨、弱升级) | 偏离指南却不说明理由,或高危病例该弃权/升级却没做 | 分诊、出院、预授权、剂量 | 指南版本化、理由编码的越轨日志、引用覆盖率、升级精确率/召回率 |
| Untraceable action chains(不可追踪动作链) | 交接、医嘱、EHR 调用失去溯源,事后无法重建”谁在什么证据、什么版本/权限下操作的” | EHR 联动动作、医嘱、交接 | provenance-first 连接器、签名交接、回滚状态 |
| Drift, jailbreak, cost shock(漂移、越狱、成本冲击) | 部署后护栏行为漂移、提示被越狱、token/延迟成本失控导致不安全或不可用 | 任何有外部用户/工具的已部署工作流 | 定期红队测试、越狱通过率、回滚手册、成本护栏、canary 发布 |
系统通向可审计、可负责任部署的路线图
短期进步不靠”多加讨论轮次”,而靠 workflow-aware 记忆、容量耦合的规划、校准好的升级策略、可审计溯源、带明确晋升门的部署手册;也就是”把状态、证据和运营控制得更紧”,而不是单纯”生成更强”。
⭐生成更强并不天然包含控制更紧。 一个模型即使生成能力很强,也可能:
- 状态交接丢字段(生成的摘要再流畅,也可能漏掉关键信息);
- 证据没有溯源(说得头头是道,却查不到依据);
- 该升级不升级(高危病例也硬着头皮下结论);
- 越轨不记录(偏离指南却不留理由);
- 运营上失败(无视床位、延迟、成本)。
建立共享报告协议(shared reporting protocol)非常有用——把工作流可观测指标、最小日志、升级覆盖率、回放证据、运营成本放在一起报告,这样系统才能放在”部署声明真正成立”的层面上被比较。
从长远来看,AI hospitals 可以看作”医疗世界模型的工作流级近似”——它维护状态、通过工具和临床接口行动、观察下游后果、在部分可观测性下重新规划。但这个视角只有在”部署证据按分阶段协议来”时才可信。
结论
人工智能医院应当被理解为工作流层面基于大语言模型的多智能体临床系统,而不是一个个独立的问答智能体。核心设计问题包括:每个业务步骤由谁负责执行;每次信息交接会保留哪些状态与证据;以及采用何种控制策略来管理流程继续执行、放弃决策与升级人工处置。
基于这一视角,评估工作应当聚焦安全、流程、结果、运维四大维度下的工作流可观测指标;系统部署则需要配套完备埋点、可直接审计的日志,以及分阶段的真实世界(IRL)准入闸门。因此,这份综述最具备复用价值的成果,不只是一套系统分类体系,更是一套面向部分可观测条件下、有状态、证据驱动、工具介导的临床工作流的结果报告与上线管控框架。