Python
环境 / 运行
命令
pip show 依赖名称
显示某一个依赖安装的位置
python -m 模块名
把一个 Python 模块(module)当成脚本来运行。
dir
当前目录的所有文件展示
虚拟环境 venv
问题
不同项目使用的环境不同,如果都放到本地去部署的话,不同项目之间的不同环境会相互覆盖
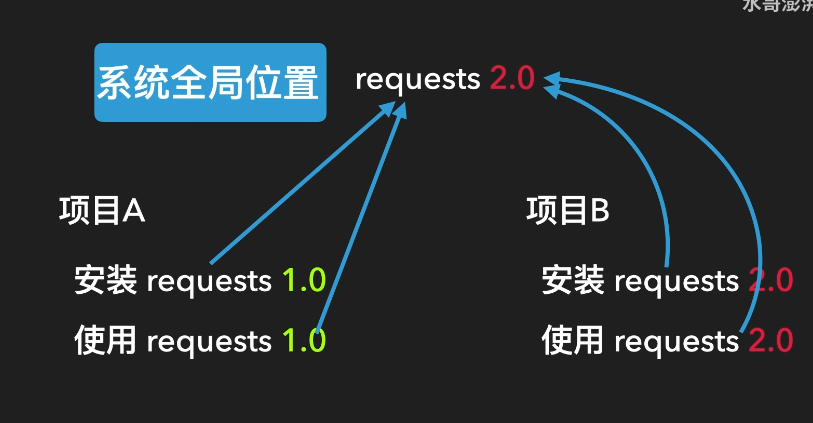
解决方法
把各自需要的依赖都放到自己项目的目录中
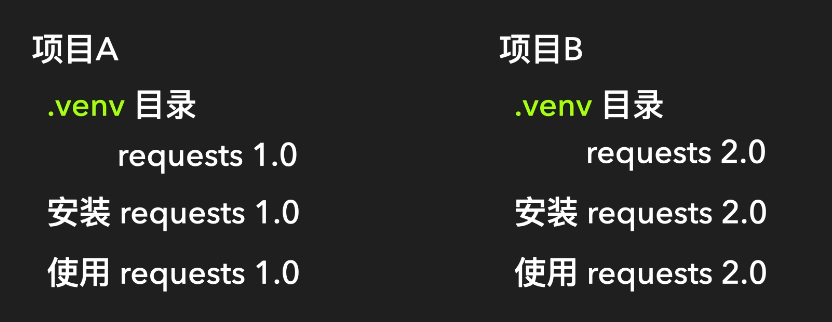
实现步骤
项目终端运行
python -m venv .venv。注意,第一个venv不可以改名称,后面的.venv是可以改的,默认是.venv项目终端运行
.venv\Scripts\activate用于激活这个虚拟环境目录,使python在解释的时候用这个目录下的环境激活之后可以比较明显的看到这个终端带了一个(.venv)的前缀
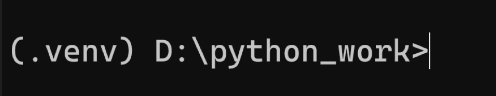
接下来在虚拟环境激活的状态下去安装依赖也是安装到这个目录了
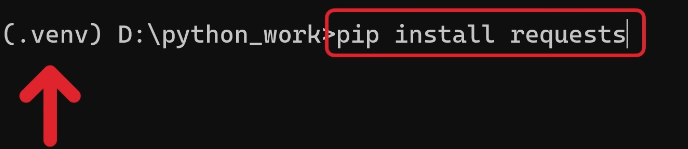
退出命令:
deactivate。或者直接把cmd窗口关掉
语言基础
循环
for
enumerate()
一边遍历,一边自动帮你编号
1 | for line_no, line in enumerate(file, start=1): |
列表推导式
1 | "experts": [ |
它的意思是:遍历 experts 里的每一个 Expert 对象,把每一个对象转换成一个字典。
1 | expert_records = [] |
函数
函数定义的语法
1 | def read_jsonl(path: str | Path) -> list[dict[str, Any]]: |
拆开:
path: str | Path:参数path的类型标注。str | Path表示”字符串或pathlib.Path两种都行”,|是联合类型(Python 3.10+ 才支持;老版本要写Union[str, Path])。-> list[dict[str, Any]]:返回值标注,从外往里读——返回一个list,列表里每个元素是dict,字典的值是Any(任意类型,不限制)。- JSONL = JSON Lines,每行一条 JSON,所以读完自然是一个”列表”,里面装着每行解析出来的”字典”。
这些标注和前面一样,只是给人和编辑器看的提示,不影响运行。
列表
创建
根据列表A创造一个标记列表flag
其中max_val为列表A的最大长度
[0] 是一个只有单个元素 0 的列表
1 | flag = [0] * (max_val + 1) |
异常
raise
1 | raise |
KeyboardInterrupt
触发场景:用户在终端按 Ctrl + C
- 系统抛出
KeyboardInterrupt - 正常不捕获的话,程序直接崩溃退出并打印一堆报错栈
EOFError
触发场景:EOF = End Of File 文件结束 。用户在终端按 Ctrl + D(Linux/macOS);Windows 是 Ctrl + Z 然后回车
- 代表标准输入结束,没有更多输入了
input()读取不到内容,抛出 EOFError
输出语句
f()函数
1 | print(f"SixSixAgents ready. Model: {agent.model}") |
f":f-string 的标记,f / F 写在引号前面,表示这个字符串支持嵌入变量 / 表达式。"SixSixAgents ready. Model: ":普通文本,原样输出。{agent.model}:花括号里面写 Python 表达式- 运行时会取出 agent.model 的值,转成字符串替换掉这整块
{agent.model}
- 运行时会取出 agent.model 的值,转成字符串替换掉这整块
input
strip()函数
作用:删除字符串开头和结尾的空白字符
1 | # 输入:" 你好啊 " |
文件
打开文件的步骤
这里结合json中的语法来演示打开文件的步骤
打开文件,然后把文件转成字符串的形式来操作
1 | text = file.read_text(encoding="utf-8") # 读取文件 → 字符串 |
config是list类型
直接读取这个文件,把文件转成列表来操作
1 | with open('test1.json', encoding='utf-8') as fp: |
其中,fp是file类型,pyth_list是list类型
两种方法可以这样写,完全等价
1 | config = json.loads(LLM_CONFIG.read_text(encoding="utf-8")) |
1 | with open(LLM_CONFIG) as fp: |
正则表达式
核心元字符
默认情况下,正则的量词(*、+、?、{n,m})是「贪婪的」—— 尽可能匹配更多字符。在量词后加 ? 可变为「非贪婪」—— 尽可能匹配更少字符。
| 元字符 | 功能说明 | 示例 |
|---|---|---|
. |
匹配任意单个字符(默认不匹配换行符 \n,部分语言可通过修饰符改变)。 |
a.b 匹配 "axb"、"a1b"、"a#b"(不匹配 "a\nb")。 |
^ |
匹配字符串开头(多行模式下匹配每行开头)。 | ^hello 匹配 "hello world"(开头是 hello),不匹配 "xhello"。 |
$ |
匹配字符串结尾(多行模式下匹配每行结尾)。 | world$ 匹配 "hello world"(结尾是 world),不匹配 "worldx"。 |
* |
匹配前面的元素 0 次或多次(贪婪匹配:尽可能多匹配)。 | ab* 匹配 "a"、"ab"、"abb"、"abbb"。 |
+ |
匹配前面的元素 1 次或多次(贪婪匹配)。 | ab+ 匹配 "ab"、"abb"(不匹配 "a")。 |
? |
匹配前面的元素 0 次或 1 次(可选匹配)。 | ab? 匹配 "a"、"ab"(不匹配 "abb")。 |
{n} |
匹配前面的元素 恰好 n 次(n 为非负整数)。 | a{3} 匹配 "aaa"(不匹配 "aa"、"aaaa")。 |
{n,} |
匹配前面的元素 至少 n 次(贪婪匹配)。 | a{2,} 匹配 "aa"、"aaa"、"aaaa"。 |
{n,m} |
匹配前面的元素 n 到 m 次(n ≤ m,贪婪匹配)。 | a{2,3} 匹配 "aa"、"aaa"(不匹配 "a"、"aaaa")。 |
| ` | ` | 逻辑「或」,匹配左边或右边的模式(优先级最低,需用括号提升优先级)。 |
() |
分组:将多个字符视为一个整体,同时捕获匹配结果(可通过反向引用使用)。 | (ab)+ 匹配 "ab"、"abab";(\w+)\s+(\w+) 捕获两个单词(如 "hello world")。 |
\ |
转义字符:取消元字符的特殊含义,或表示预定义字符类(如 \d、\s)。 |
a\.b 匹配 "a.b"(. 作为普通字符);\* 匹配 "*"。 |
[] |
字符类:匹配括号内任意一个字符(支持范围表示,^ 表示否定)。 | [abc] 匹配 "a"、"b"、"c";[^abc] 匹配非 a/b/c 的字符。 |
[-] |
字符类内的范围符:表示连续字符集(如字母、数字范围)。 | [a-z] 匹配小写字母;[0-9] 匹配数字;[a-zA-Z0-9] 匹配字母数字。 |
什么叫匹配前面的元素?
比如ab*,* 只作用于 b,不是作用于整个 ab。所以它匹配:
1 | a # b 出现 0 次 |
预定义字符类
为了简化常见的字符匹配,正则提供了预定义的字符类(部分需结合修饰符使用):
| 预定义类 | 等价于 | 功能说明 |
|---|---|---|
\d |
[0-9] |
匹配任意数字(digit)。 |
\D |
[^0-9] |
匹配任意非数字。 |
\w |
[a-zA-Z0-9_] |
匹配字母、数字、下划线(word 字符,注意不包含空格和特殊字符)。 |
\W |
[^a-zA-Z0-9_] |
匹配非字母、数字、下划线。 |
\s |
[ \t\n\r\f\v] |
匹配任意空白字符(space:空格、制表符 \t、换行符 \n 等)。 |
\S |
[^\t\n\r\f\v] |
匹配任意非空白字符。 |
\b |
- | 匹配单词边界(单词与非单词的分隔处,如 "hello world" 中的空格两侧)。 |
\B |
- | 匹配非单词边界(如 "helloworld" 中两个单词的连接处)。 |
\n |
- | 匹配换行符(部分语言支持 \r\n 匹配 Windows 换行)。 |
\t |
- | 匹配制表符。 |
示例:
\d{3}-\d{4}匹配"123-4567"(3 位数字 + 横杠 + 4 位数字)。\w+@\w+\.\w+匹配简单邮箱(如"test123@example.com")。\bhello\b匹配独立的单词"hello"(不匹配"helloworld"或"xhello")。
核心特性
贪婪匹配与非贪婪匹配
默认情况下,正则的量词(*、+、?、{n,m})是「贪婪的」—— 尽可能匹配更多字符。在量词后加 ? 可变为「非贪婪」—— 尽可能匹配更少字符。
| 模式 | 类型 | 示例(匹配字符串 "aabbaabcc") |
|---|---|---|
a.*b |
贪婪 | 匹配 "aabbaab"(从第一个 a 到最后一个 b)。 |
a.*?b |
非贪婪 | 匹配 "aab"(从第一个 a 到最近的 b)。 |
a.+c |
贪婪 | 匹配 "aabbaabcc"(从第一个 a 到最后一个 c)。 |
a.+?c |
非贪婪 | 匹配 "aabbaabc"(从第一个 a 到最近的 c)。 |
分组与捕获
() 不仅能将模式分组(视为整体),还能「捕获」匹配到的内容,后续可通过「反向引用」或编程接口获取。
(1)普通捕获组
- 语法:
(pattern) - 捕获的内容按分组顺序编号(从 1 开始),可通过
\1、\2…(正则内)或编程变量(如 Python 的group(1))引用。
示例:
匹配重复单词:
(\w+)\s+\1解释:(\w+)捕获第一个单词,\s+匹配空格,\1引用第一个捕获的单词,可匹配"hello hello"、"test test"。提取日期中的年、月、日:
(\d{4})-(\d{2})-(\d{2})匹配"2025-11-21"后,捕获组 1 ="2025",组 2 ="11",组 3 ="21"。1
2
3
4
5
6
7
8
9import re
text = "今天是 2025-11-21"
match = re.search(r"(\d{4})-(\d{2})-(\d{2})", text)
print(match.group(0)) # 2025-11-21
print(match.group(1)) # 2025
print(match.group(2)) # 11
print(match.group(3)) # 21
(2)非捕获组
若只需分组(不捕获结果),用 (?:pattern),可提升性能(避免不必要的内存占用)。
示例:
(?:ab)+匹配"ab"、"abab"(不捕获"ab",仅作为整体匹配)。1
2
3# 区别为
(ab)+ 分组 + 捕获
(?:ab)+ 只分组,不捕获
(3)命名捕获组
为捕获组命名,便于后续引用(避免按编号混淆),语法:(?<name>pattern)(部分语言支持,如 Python、JavaScript、Java)。
示例:
- 提取日期:
(?<year>\d{4})-(?<month>\d{2})-(?<day>\d{2})匹配后可通过名称引用(如 Python 的group("year")),更直观。
零宽断言
零宽断言是「匹配位置」的模式,不消耗字符(仅判断当前位置前后是否满足条件),分为「先行断言」和「后行断言」。
(1)先行断言(Lookahead)
判断当前位置后面是否满足条件,语法:
- 正向先行:
(?=pattern)→ 后面必须是 pattern。 - 负向先行:
(?!pattern)→ 后面必须不是 pattern。
示例:
- 匹配「后面是数字的字母」:
[a-zA-Z](?=\d)匹配"a1"中的"a"、"b23"中的"b"(后面必须跟数字)。 - 匹配「后面不是数字的字母」:
[a-zA-Z](?!\d)匹配"ab"中的"a"、"c#"中的"c"(后面不是数字)。 - 验证密码(必须包含数字):
^(?=.*\d).{6,12}$解释:^开头,(?=.*\d)后面必须有至少一个数字,.{6,12}匹配 6-12 个任意字符,$结尾。
(2)后行断言(Lookbehind)
判断当前位置前面是否满足条件,语法:
- 正向后行:
(?<=pattern)→ 前面必须是 pattern。 - 负向后行:
(?<!pattern)→ 前面必须不是 pattern。
示例:
- 匹配「前面是数字的字母」:
(?<=\d)[a-zA-Z]匹配"1a"中的"a"、"23b"中的"b"(前面是数字)。 - 匹配「前面不是数字的字母」:
(?<!\d)[a-zA-Z]匹配"xa"中的"a"、"#b"中的"b"(前面不是数字)。 - 提取「$ 后面的数字」:
(?<=\$)\d+匹配"$123"中的"123"、"price: $45"中的"45"\(前面是 $)。
库
argparse 库
argparse 是 Python 标准库,用来解析命令行参数。
典型用途:
1 | python main.py --model gpt-5.6 --prompt "你好" |
Python 程序可以通过 argparse 获取:
1 | args.model |
基本使用流程
argparse 的核心 3 步:
1 | import argparse |
可以记成:
1 | ArgumentParser() |
ArgumentParser()
1 | parser = argparse.ArgumentParser( |
description:用于描述程序的功能。这也是最常用的一个参数,其他参数暂时不用记
add_argument()
作用:告诉 argparse程序有哪些命令行参数
例如:
1 | import argparse |

位置参数 vs 选项参数
位置参数:不带 --
1 | import argparse |
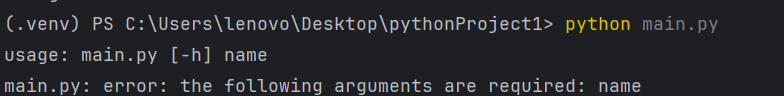
运行 python main.py ZhangSan正常运行

但是当运行python main.py 会报错。
选项参数:带 --
1 | import argparse |
但是当去掉参数的时候不会报错,会显示None值。

JSON库
JSON 文件/响应中的内容通常是 JSON 格式的文本(字符串),Python 需要用 json 模块把 JSON 文本解析成 Python 对象。转为字典或者列表格式
| 常量、类或者方法名 | |
|---|---|
| json.dump | 方法,传入一个json对象,将其编码为json格式后储存到io流中 |
| json.dumps | 方法,传入一个python对象,将其编码为json格式后储存到str中 |
| json.load | 方法,传入一个json格式的str,将其解码为python对象 |
| json.loads | 方法,传入一个json格式的str,将其解码为python对象 |
loads用法
loads 处理字符串
1 | import json |
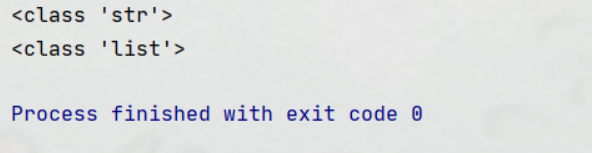
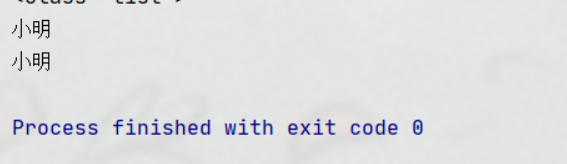
然后我们就可以获得其中的数据了
1 | name = new_data[0]['name'] |
load用法
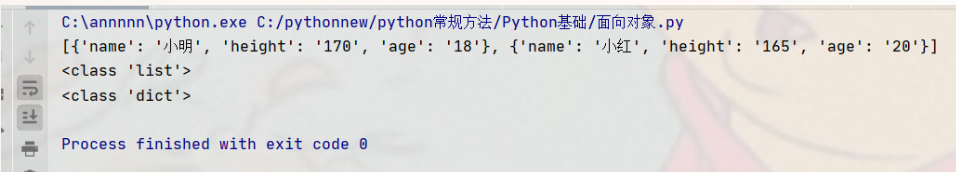
load 处理文件对象。
注意:load方法操作的是整个文件对象,这里是将整个文件对象里面的内容转化为json对象。(下图是文件操作对象)

1 | import json |
dumps函数
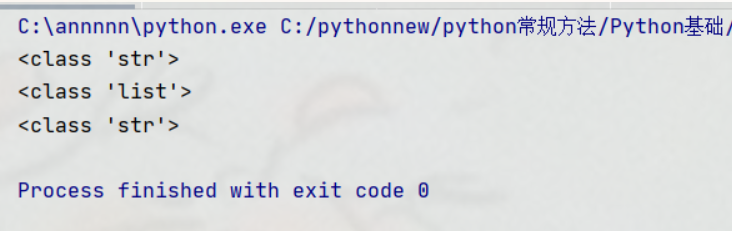
json.dumps()函数,把python类型的数据转换成json字符串
1 | import json |
dump函数
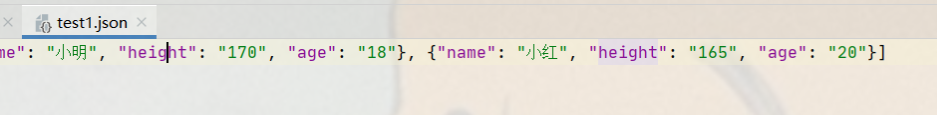
把python类型的数据以json格式储存到文件中
1 | import json |
toml文件
TOML 是一种配置文件格式,语法比 JSON 更适合手写。Python 3.11 起内置了 tomllib 模块用来解析 TOML,不需要额外 pip 安装。如果项目跑在 3.10 及更早版本,才需要安装第三方库 tomli。
| 方法 | 说明 |
|---|---|
tomllib.load |
传入一个二进制文件对象,把 TOML 内容解析成 Python 字典 |
tomllib.loads |
传入一个 TOML 格式的字符串,解析成 Python 字典 |
注意:tomllib 只支持读取,不支持把 Python 对象写回 TOML 文件(要写回得用 tomli-w)。所以 JSON 那套 dump / dumps 在这里是没有对应方法的。
load用法
和 json.load() 最大的区别是:文件必须用二进制模式打开,也就是 "rb",不能用 "r"。
1 | import tomllib |
表头嵌套会解析成嵌套字典
TOML 用 [表名.子表名] 表示层级,点号每多一个就多嵌套一层。解析成 Python 后就变成一层套一层的字典。
1 | [model_providers.custom] |
解析结果:
1 | { |
关键点:[model_providers.custom] 不是一个名叫 "model_providers.custom" 的键,那个点号表示嵌套。所以下面这样写是取不到值的:
1 | config.get("model_providers.custom") # 结果是 None |
必须分成两层去取:
1 | providers = config.get("model_providers", {}) # 第一层,得到 {"custom": {...}} |
等价于:
1 | provider = config["model_providers"]["custom"] |
类型转换
tomllib 会把 TOML 的值转成对应的 Python 类型:
| TOML | Python |
|---|---|
"abc" |
str |
1 |
int |
1.0 |
float |
true / false |
True / False(bool) |
[1, 2, 3] |
list |
[a.b] 表 |
dict |
| 日期时间 | datetime |
实测:
1 | custom = config["model_providers"]["custom"] |
完整例子:读取 Codex 的 config.toml
1 | model_provider = "custom" |
1 | import tomllib |
几个容易混淆的点:
model_provider(单数)和model_providers(复数)是两个不同的键。单数回答”选哪个”,复数回答”都有哪些”。[model_providers.custom]的点号表示层级,解析后是嵌套字典,不是键名的一部分。- 取值链条要和结构对应:
config["model_providers"]["custom"]。 - 代码里不写死
"custom",而是先读model_provider,再拿这个名字去查。这样以后换 provider 不用改代码。 dict.get(key, 默认值)在键不存在时会返回默认值而不报错,比如providers.get(provider_name, {})的第二个参数就是兜底的空字典。
Http库
HTTPX
httpx.Client(...)
创建一个可复用的 HTTP 客户端对象。即创建“请求工具”,此时没有访问网络
1 | httpx.Client( |
base_url:统一设置接口基础地址,后面请求相对路径。headers:放Authorization、Content-Type等请求头。timeout:设置网络请求超时时间。follow_redirects:是否自动跟随重定向,默认是False。verify:HTTPS 证书验证,默认是True,通常不用写。proxy:需要通过代理访问接口时使用。
client.get()
使用这个工具请求某个 URL
1 | response = client.get( |
params:添加 URL 查询参数。1
2
3
4client.get(
"https://example.com/search",
params={"q": "python", "page": 1},
)实际请求地址会变成:
https://example.com/search?q=python&page=1重复参数可以使用列表:
1
2
3
4client.get(
"https://example.com/search",
params=[("tag", "python"), ("tag", "http")],
)结果为:
https://example.com/search?tag=python&tag=httpheaders:为当前请求增加或覆盖请求头。1
2
3
4
5
6
7client.get(
"https://example.com/data",
headers={
"Authorization": "Bearer sk-xxx",
"X-Request-ID": "abc123",
},
)timeout:覆盖客户端设置的超时时间。1
client.get("https://example.com", timeout=5.0)
也可以使用详细超时:
1
2
3
4
5
6
7
8
9client.get(
"https://example.com",
timeout=httpx.Timeout(
connect=3.0,
read=30.0,
write=5.0,
pool=5.0,
),
)follow_redirects:指定当前请求是否跟随重定向。1
2
3
4client.get(
"https://example.com/old",
follow_redirects=True,
)