MDAgents: an adaptive collaboration of LLMs for medical decision-making
从单个的llm创造多个会话来模拟医生到创建agent来管理,然后演变为多个agent互相协调,最后提出不应该用LLM 工作流来评估这个工作流程,而是使用AI加医生
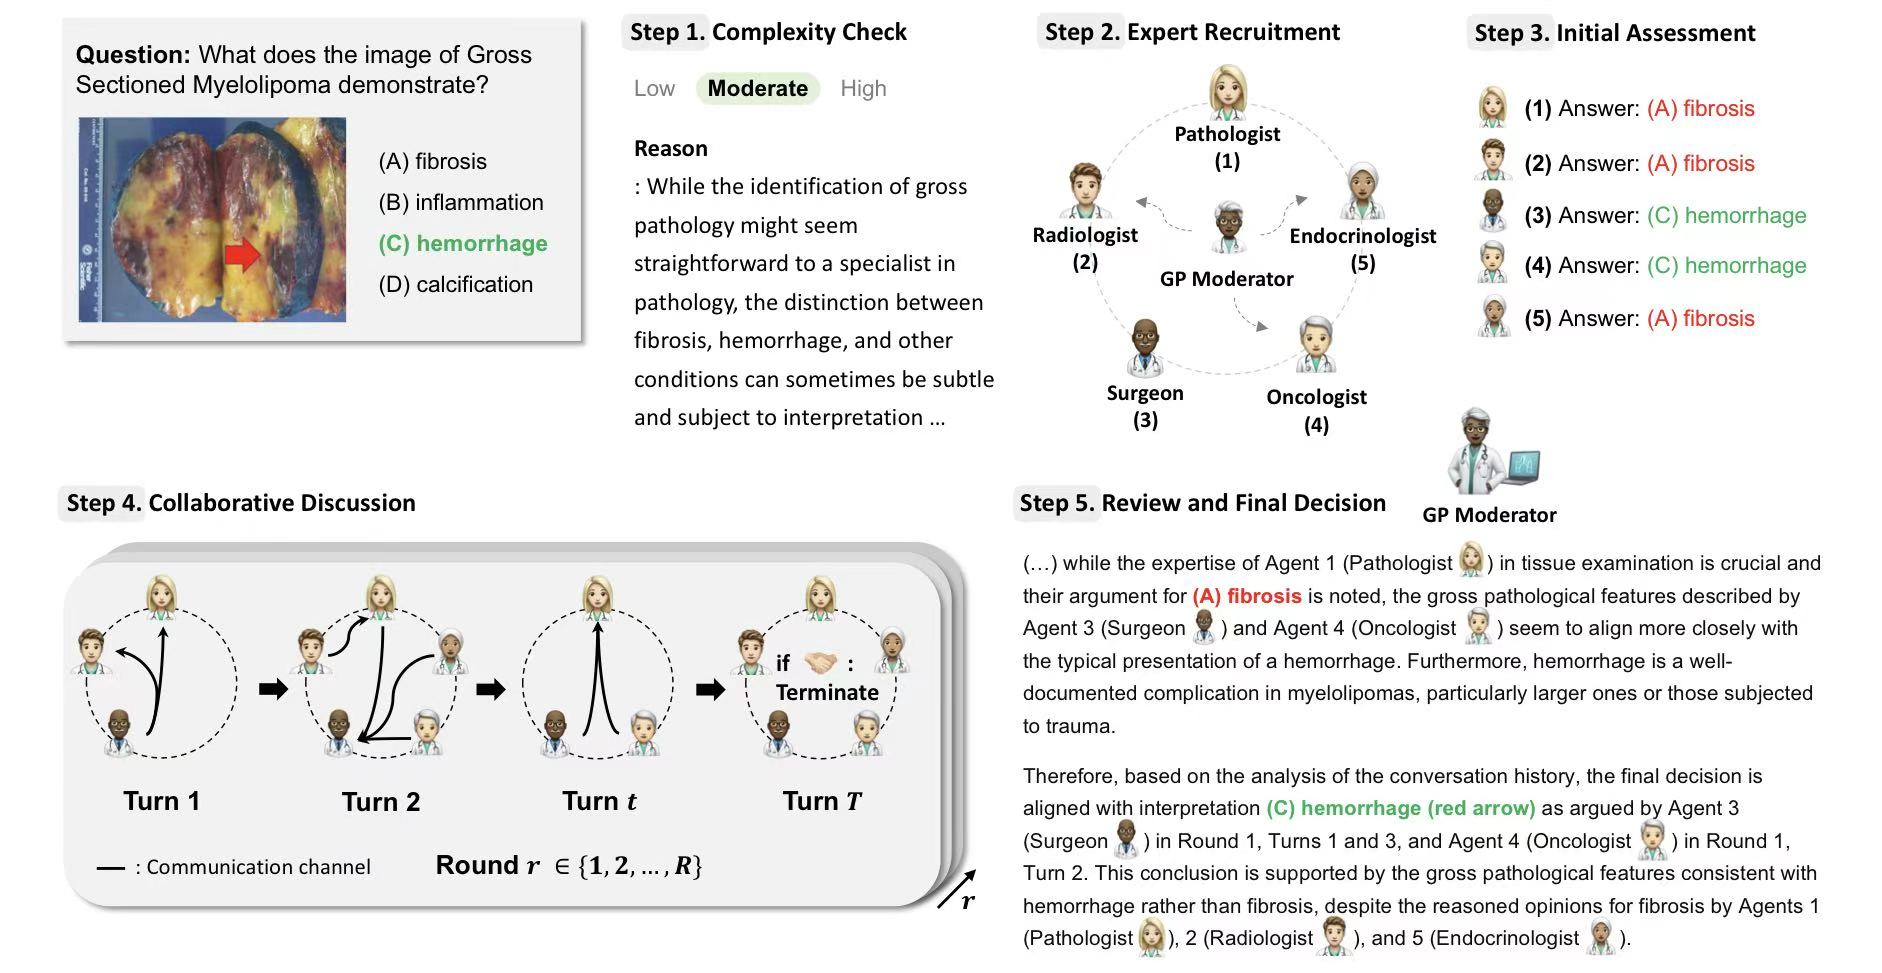
系统实现流程
使用的测试集
| 类别 | 数据集 | 输入形式 | 大致考察什么 |
|---|---|---|---|
| Medical Knowledge Retrieval | MedQA | 文本 | 医学执照考试/临床医学知识与推理 |
| PubMedQA | 文本 | 基于 PubMed 文献进行医学研究问答 | |
| Path-VQA | 图像 + 文本 | 病理图像问答 | |
| PMC-VQA | 图像 + 文本 | 医学论文中的图片 + 文本问答 | |
| MedVidQA | 视频 + 文本 | 医学视频理解与问答 | |
| Clinical Reasoning & Diagnostic | DDXPlus | 文本 | 症状 → 疾病诊断 |
| SymCat | 文本 | 症状 → 疾病 | |
| JAMA | 文本 | JAMA 临床病例诊断 | |
| MedBullets | 文本 | 医学教育/临床推理题 | |
| MIMIC-CXR | 图像 + 文本 | 胸部 X-ray 医学影像诊断 |
step1:复杂度分析
由Moderator来判断
简单问题:
“这张胸片有没有肺部异常?”
这种问题图像特征比较明显且不需要复杂医学推理,一个 agent 可能就能回答
那么复杂度检查后可能认为:低复杂度 → 少量 agent (这个MD系统写提示词)→ 快速回答
复杂问题:
“患者有这些症状,结合 CT 图像,判断最可能的诊断,并解释鉴别诊断依据。”
这种问题:涉及多个医学知识领域、需要图像分析、需要推理、需要排除其他疾病,所以可能需要多个agent
那么复杂度检查后可能认为:高复杂度 → 调用更多 agent (这个MD系统写提示词)→ 让不同角色协作
step2:专家招募
程序设定最多招募几个llm扮演的专家(论文中最多设置了五个),由Moderator进行思考招募几个专家。
step3:提交初始建议
由LLM扮演的专家进行答案的推送
step4:合作讨论
这里GP moderator并不参与。由于各个llm的上下文严格意义上是各自独立封存的。这个时候需要把所有的上下文都放到全局变量中,由各个llm进行访问。这样就形成了合作讨论的环节。论文里设定了最多讨论五个turn(可以更改)
step5:审查与最终讨论
当上一步设置的轮数有确切的答案。输出最终答案
如果没有确切的答案,那么moderator介入讨论进行信息整合
大概过程如下:
1 | Initial Assessment |
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 ctyyy的博客!