MedAgents: large language models as collaborators for zero-shot medical reasoning
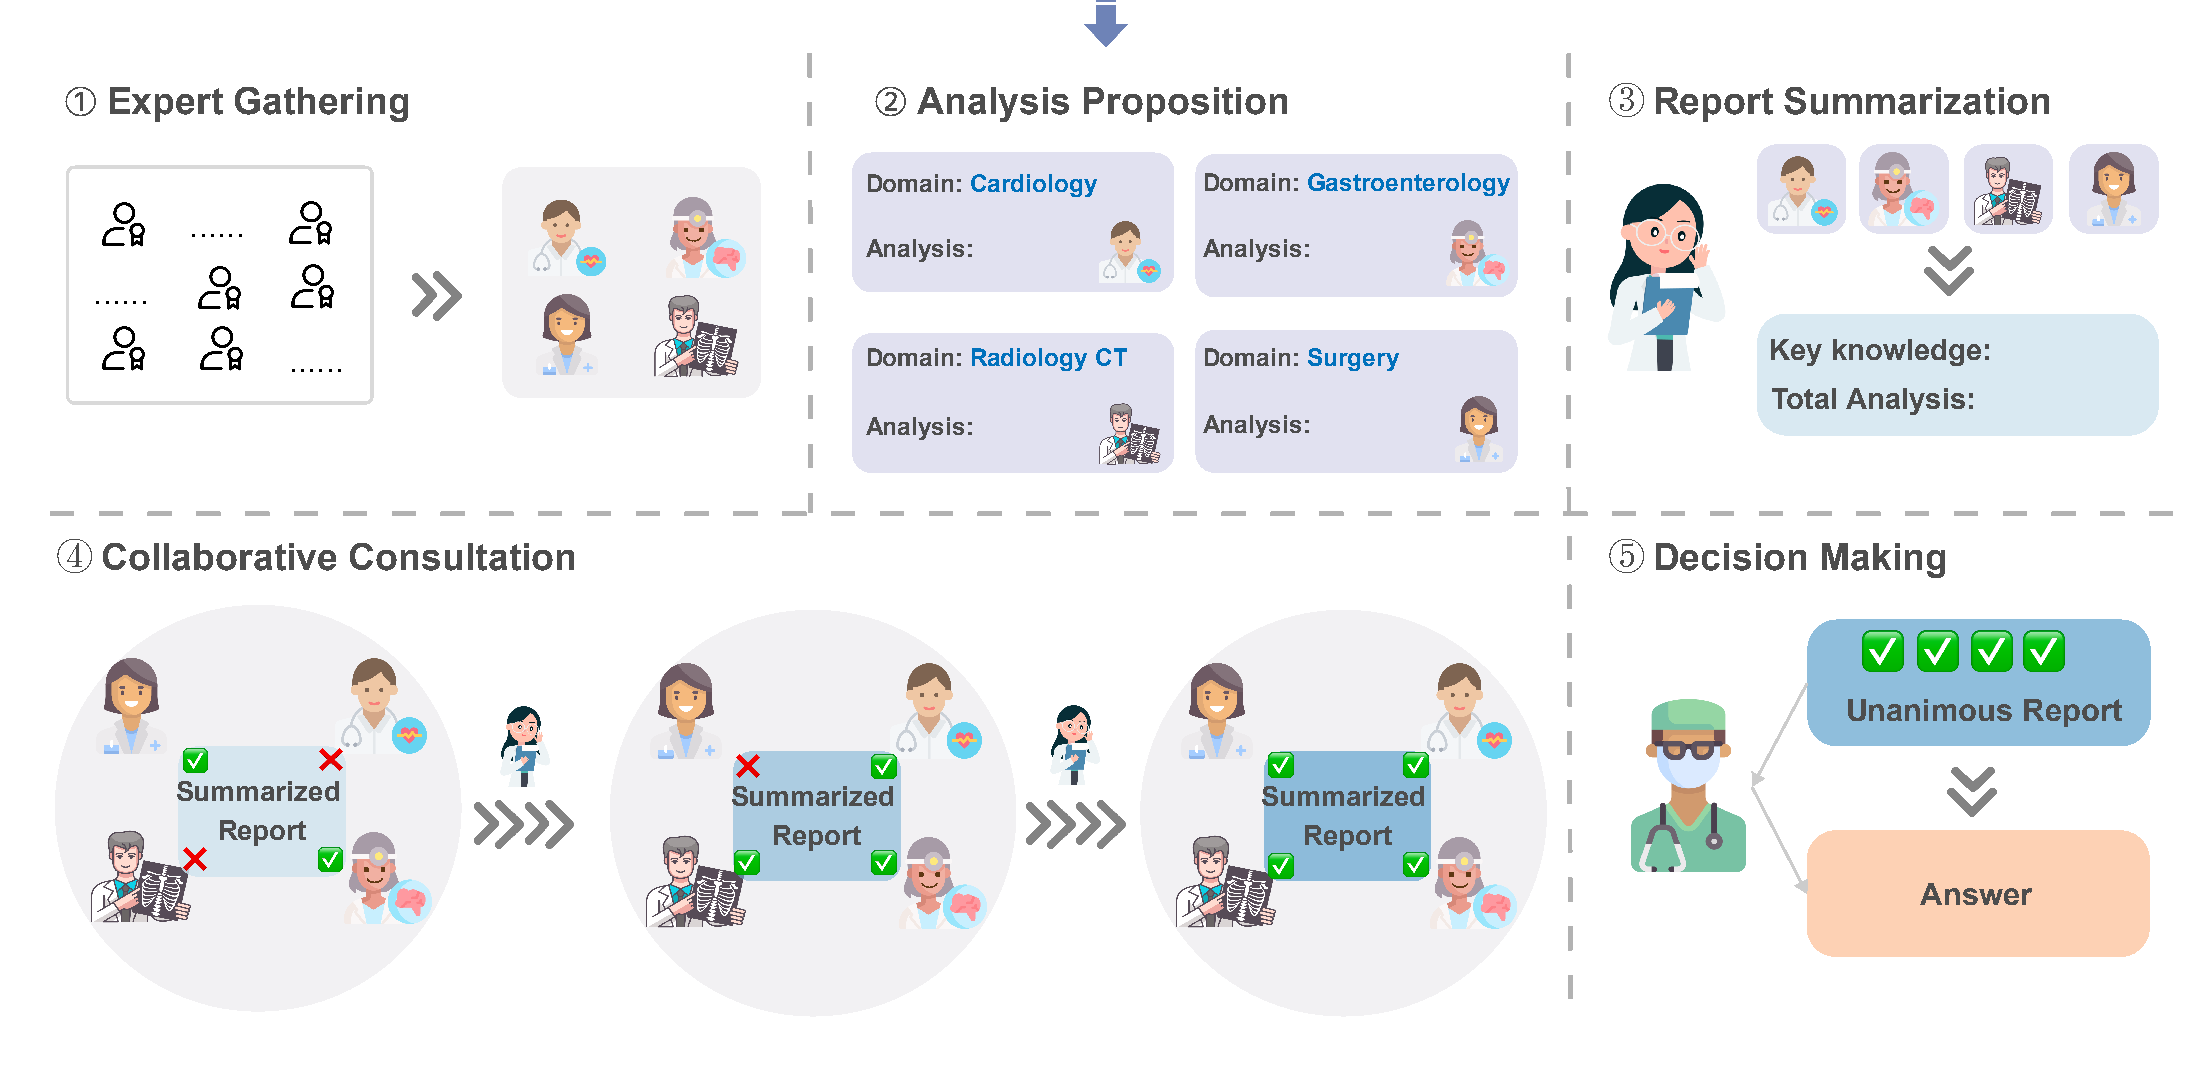
MedAgents的五阶段流程图
方法
⭐这个方法全程自动,从input到output全程不需要人
q= 题目(question)op= 一堆选项,o1...ok就是第 1 到第 k 个选项QD= 问域专家(question-domain experts),默认 5 个,专门分析题目属于什么专科`OD= 选项域专家(option-domain experts),默认 2 个,专门判断每个选项对不对QA/OA= 这两拨专家写出的分析Repo= 汇总报告,Repof是最终全员同意的报告ans= 最终答案r.../prompt...= 角色描述和指示语,把它们当成“给 LLM 的工牌 + 任务单”就行
1. 组建专家小组
论文里的“不同专家”不是真医生、也不是独立模型,而是同一个大模型在每次调用时换一个系统角色描述和任务提示:一次让它自称心内科主任,另一次让它自称消化科主任,再让另一组扮演“专门挑选项毛病”的专家。区别全在 prompt 和角色设定上,参数都是公开的 GPT-3.5/GPT-4,论文实验提到 temperature=1.0,所以同一角色反复调用时输出还带随机性。
QD = LLM(q, rqd, promptqd):拿题目问模型“这题需要哪些专科”;
OD = LLM(q, op, rod, promptod):再问模型“要判断这些选项,还需要哪些专科”。
2. 每个LLM独立写意见
qai(LLM)= LLM(q, qdi, rqa, promptqa):让问域专家 qdi 只针对题目写分析。
oai (LLM)= LLM(q, op, odi, QA, roa, promptoa):让选项域专家 odi 拿着题目、所有选项,还附上问域专家的分析,逐个评估选项。
先让内科、外科这些“管题的人”各写一段病情分析;再把他们的分析交给“管选项的人”,让他们结合分析去判断每个选项为什么对、为什么错。这里的关键点是信息传递顺序:先有题目分析,选项分析才能做。
3. 报告与汇总
即把不同LLM role 意见合成一份会诊报告
Repo = LLM(QA, OA, rrs, promptrs):把所有专家分析丢给一个“报告助手”,提炼成“关键知识 + 总分析”。
4.协作会诊
即多轮投票,改到全员通过为止
问题和选项的领域专家数量设置为: m = 5, n = 2 PubMedQA 为 (m = 4, n = 2)。最大尝试次数 t 设置为 5。 我们为每个数据集随机采样 300 个示例,并 在它们上进行实验。统计上,我们方法的价格 为 100 个 QA 示例的 1.41 元(每个问题约 ¢1.4 元),每个示例的推理时间约为 40s。
1 | Algorithm 1: Collaborative Consultation |
1 | Algorithm 1: 协作会诊(Collaborative Consultation) |
5. 决策
要求大模型拍板
ans = LLM(q, op, Repof, promptdm):让“医学决策者”根据最终一致报告,从选项里选出答案。
分析(因为LLM毕竟是个黑盒子)
向内agent分析
五阶段里,每个中间步骤到底有没有用?做法是在 MedQA 上一个一个“加装”阶段,看准确率怎么变:
| 配置 | MedQA 准确率 | 相比上一档 |
|---|---|---|
| Direct Prompting(直接问答案) | 49.0% | 起点 |
| CoT Prompting(只加思维链) | 55.0% | +6.0 |
| + Analysis(加个体专家分析) | 62.0% | +7.0 |
| + Summarization(加报告汇总) | 65.0% | +3.0 |
| + Consultation(加协作会诊) | 67.0% | +2.0 |
结论很明确:每个环节都贡献提升,但贡献不平等。个体专家分析是最大增量(+7),说明“角色化让 LLM 把知识挖出来”是整个框架的主力;报告汇总再补 3 分,会诊只再补 2 分,后面两位主要起验证和修正作用,不是性能引擎。
向外agent分析
同一个模型,换一种多人协作的组织方式,能把知识用得更好吗?
同一个模型下的变量有三个:
- Few-shot:在提问之前给模型几个手写的示范例子,格式是
Q: 问题 A: 答案是...。 - Few-shot CoT:示范例子不变,但每个例子里都多写一段推理过程,也就是先给理由、再给答案。
- SC(Self-Consistency,自洽采样):同一个问题采样多条推理链,最后少数服从多数。论文自己的实现是采样 5 次、temperature 设为 0.7
结果:
- 大幅超过“直接问答案”的零样本基线。GPT-4 上平均分从 80.6 提到 86.7,高出约 6 分;GPT-3.5 上从 67.8 提到 72.1。即不用微调、不用检索,靠协作流程就能赢过裸模型。
- 零样本条件下追平甚至压过“带示例”的强基线 Few-shot CoT+SC。GPT-4 是 86.7 对 85.4,GPT-3.5 是 72.1 对 71.6。这意味着 MedAgents 达到了 few-shot 提示的水平,却不需要任何人写示范例子。
- 收益不均衡,不能宣称处处都赢。比如 GPT-3.5 在 PubMedQA 上 MedAgents 只有 72.9,低于 Zero-shot CoT + SC 的 75.7。Table 2 里还能看到另一个现象:单独的 CoT 在某些数据集上反而掉分,比如 GPT-4 的 MedQA 从 Zero-shot 73.0 降到 Zero-shot CoT 61.8。论文把这解释为医疗领域 CoT 可能诱发幻觉,而多智能体角色扮演能缓解这个问题。
MedAgents 在九套静态医学题上,零样本、无训练、无 RAG,却同时做到了“远超裸模型、追平最强带示范提示”的效果;但收益要看数据集,不是所有地方都更优。
和其他开源模型相比怎么样?
这些开源医学微调模型当时不够强( 2024 年前后的模型水平,后来 Llama、Qwen 等开源模型进步很快,开源也是可能打过闭源的),追不上通用大模型,于是作者干脆不往“微调医学模型”这个方向走,改用 GPT 加多智能体提示流程。
⭐所以早期医疗 MAS 普遍搭在 GPT 等闭源 API 上,而不是开源模型上。
Agent数量
Agent 数量不是越多越好。论文证明加专家确实比不加好;最优数量各数据集一致,是 5 个问题域专家加 2 个选项域专家。再加多或配比不对,收益并不继续涨。
多样性 vs 同质化
测试集介绍
| 名称 | 全称/来源 | 考什么 | 题目形式 | 论文里的规模 |
|---|---|---|---|---|
| MedQA | 美国执业医师资格考试风格题库 | 临床推理、诊断、治疗决策 | 四到五选一 | 1273 题 |
| MedMCQA | 印度医学院入学考试(AIIMS/NEET PG) | 医学基础知识与临床题 | 四选一 | 约 6.1K 题 |
| PubMedQA | 基于 PubMed 论文摘要的问答集 | 医学文献理解与推断 | Yes / No / Maybe | 500 题 |
| MMLU | 通用“大规模多任务语言理解”基准 | 涵盖各学科,不只是医学 | 四选一多项选择 | 取 6 个医学子任务共 1089 题 |
测试结果
| 配置(都是 6 个左右专家) | MedQA | MedMCQA |
|---|---|---|
| 6 个不同领域 | 64.1 | 59.3 |
| 6 个相同领域 | 59.2 | 58.1 |
| 5 个相同领域 | 57.5 | 57.3 |
| 4 个相同领域 | 55.9 | 57.0 |
同样的人数,把领域换成重复的,分数一路往下掉。领域多样性要比专家数量更重要。
补充:删掉哪个领域的agent影响最大?
删最相关领域明显掉分,删最不相关领域反而轻微提升。也就是说专家不是“请得越多越好”,请错人(选了可有可无甚至多余的专业)会拖后腿,专家组合的相关性很重要。
缺点分析
主要分析系统答错的时候,错在哪里。
论文随机抽了 MedQA 和 MedMCQA 里的 40 个错误案例做人工分类,把错误归成四类:
- Lack of Domain Knowledge:模型不知道这个医学知识;
- Mis-retrieval of Domain Knowledge:知识学过,但调用错了或没用到对的上下文;
- Consistency Errors:对同一句话给出前后矛盾的反应;
- CoT Errors:推理链本身推导错误。
约 77%的错误来自前两类合并的“领域知识问题”(缺乏 + 误检索)。多数失败不是“推理不会推”,而是“知识本身超出 LLM 内部范围”。作者也承认这个问题:协作能把已有知识组织起来,但补不了缺失的知识。
局限性
- 大语言模型内部的参数化知识会随时间推移发生过时,因此需要持续投入工作以维持该框架的时效性。
- 在框架的不同阶段接入多种不同模型,会是一个颇具研究价值的探索方向。
- 该框架在低资源语言场景下适用性有限。将本框架适配到更多低资源语言,能够在一定程度上满足这些语言地区的特定医疗需求。