Not just one agent: LLM-based multi-agent systems for medicine from answer generation to accountable workflow orchestration
摘要
医学 MAS 不应作为更大的 LLM 工作流来评估,而应作为临床协调基础设施,在人工与智能体团队之间重新分配证据、责任和风险。
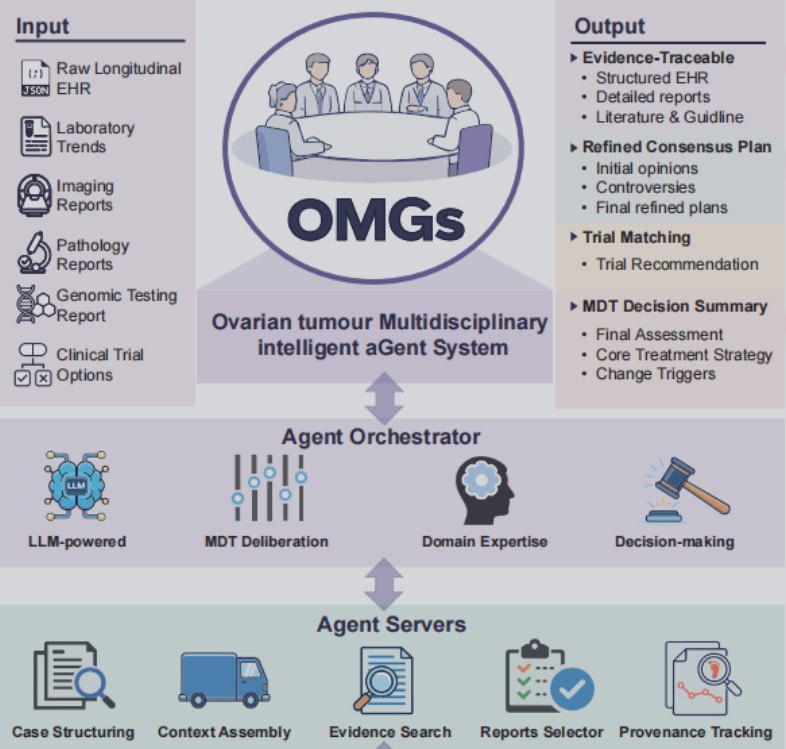
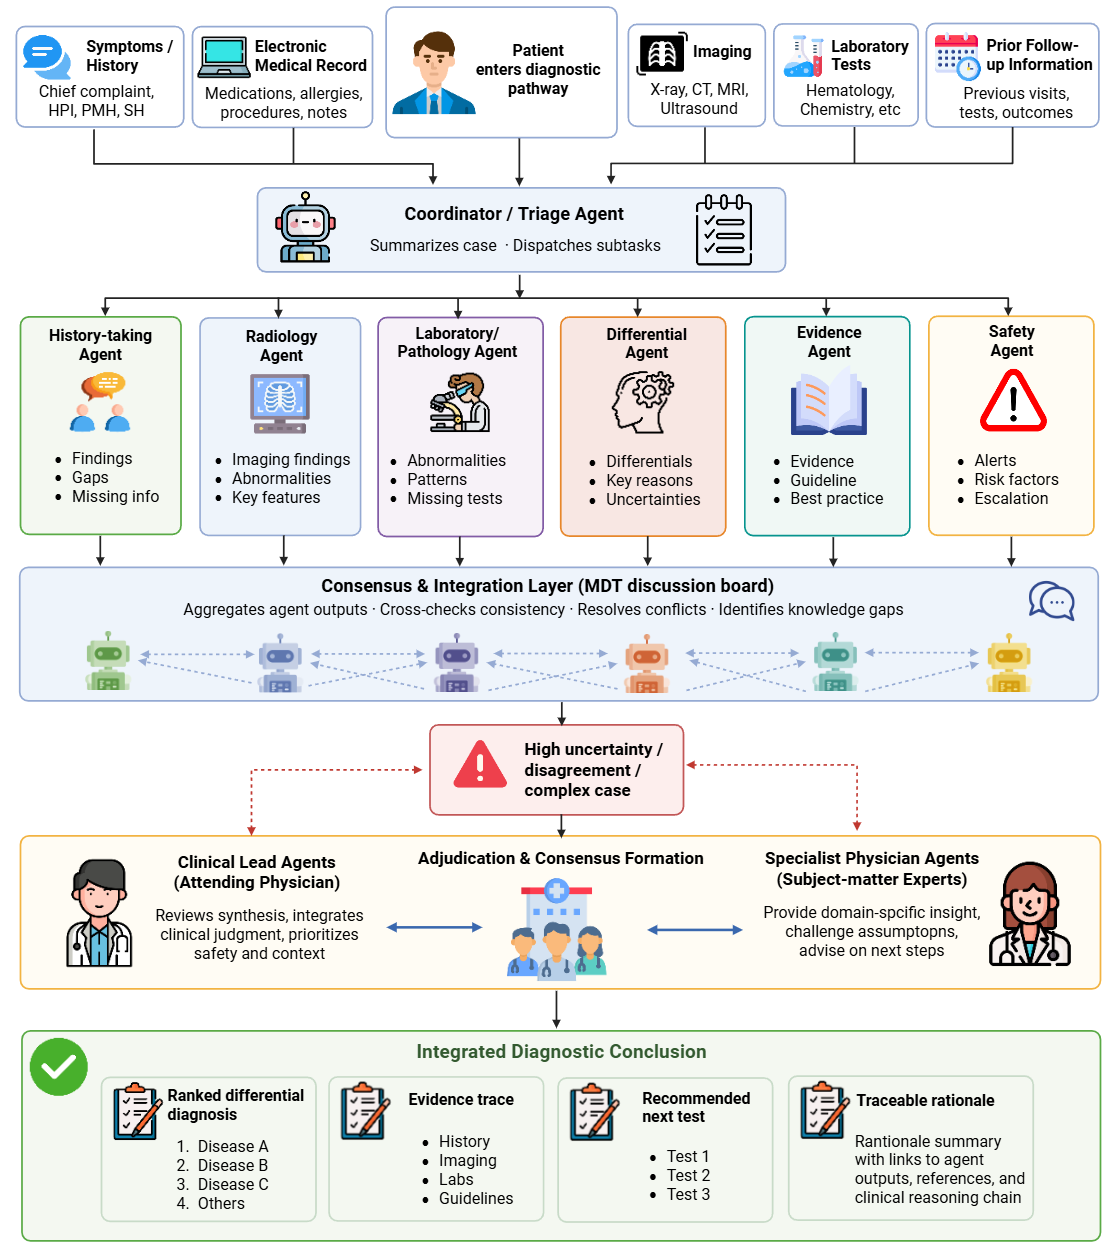
论文提出的 MDT 风格 MAS 运行流程:
评估系统和临床验证标准
基本框架
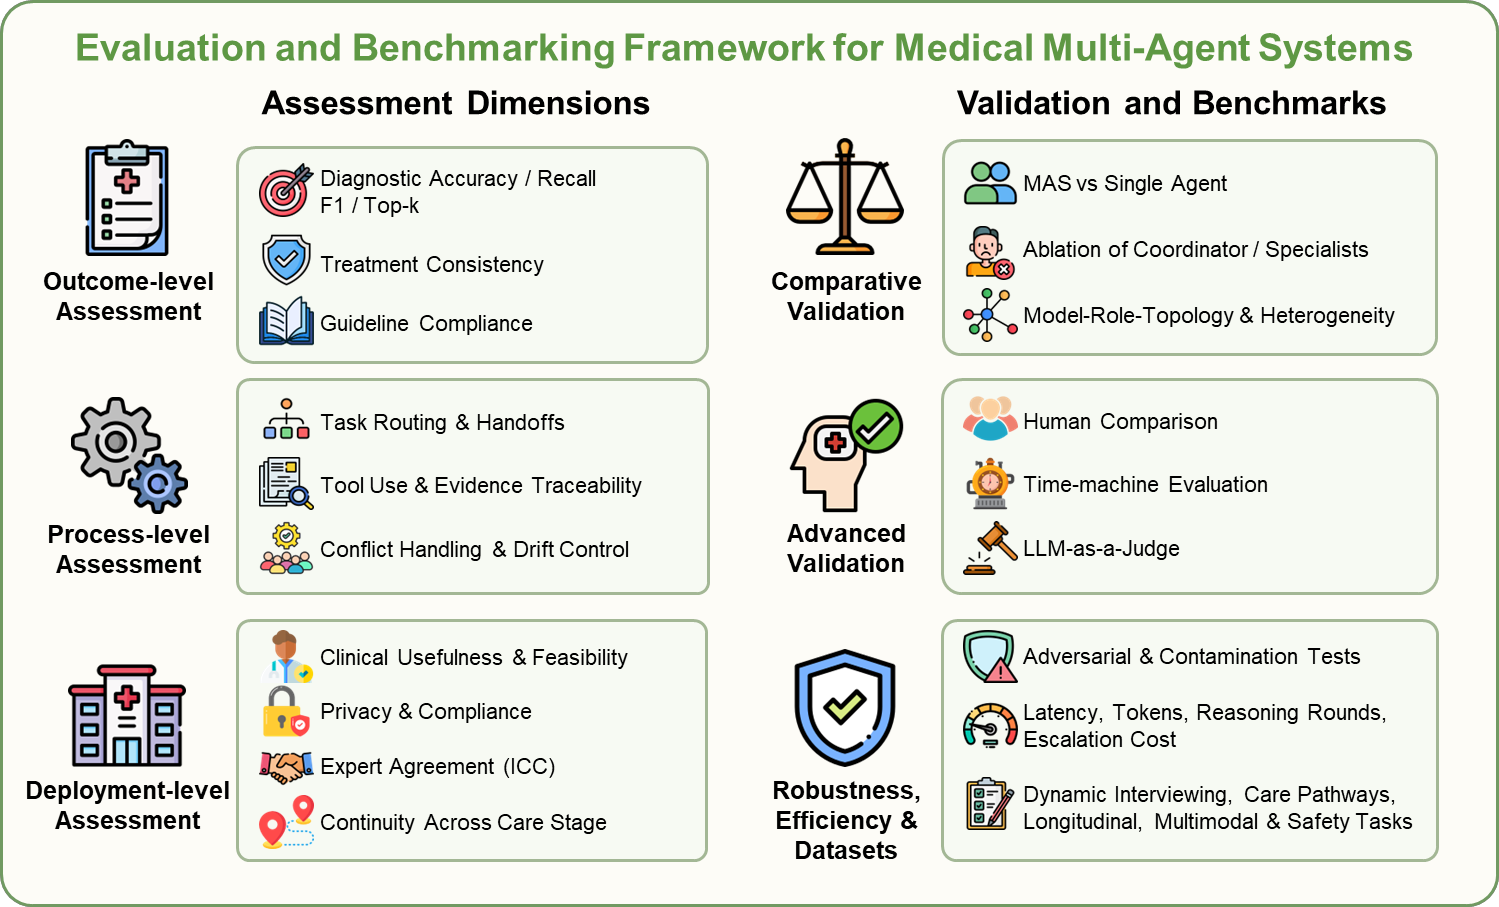
左侧总结了结果级、过程级和部署级的评估维度;右侧重点介绍了比较性和高级验证方法,以及鲁棒性、效率和代表性基准数据集和任务。
评估指标
- 结局层:对医学 MAS 的评估首先要保留基本结果级指标,如诊断准确率、召回率、F1 分数、top-k 命中率、治疗建议一致性以及指南一致性。这些指标能说明系统结论是否具有临床可接受性,但解释不了这些结论是如何形成的。
- 过程层:对 MAS 来说,更关键的问题是协作过程本身是否可靠,包括任务路由是否恰当、智能体之间的信息交接是否完整、外部工具使用是否正确、证据来源是否清晰,以及在多轮协作后结论是否缺乏正当理由地漂移。
- 部署层:从”跑分好看”到”能不能进真实医院”,即临床可执行性。看输出能否被真实临床执行:比如医嘱集不只是判对错,而是让医生按 accuracy / usefulness / feasibility / impact 评分;以及多阶段工作流(分诊→检验→诊断→治疗)能否保持连续完整。
高级评估方法:时间回溯
时间回测的关键思想并非回顾性重做案例,而是把 MAS 放在案例结束前的某个历史时间点,只允许它访问当时真正可获取的信息。这用来评估共享状态和中间证据是否足以支持早期决策。
关键临床信息往往并非一次性提供,而是通过患者智能体与系统智能体之间的交互逐步揭示。因此必须把询问过程纳入评估,避免对 MAS 能力过度乐观。相关研究已开始使用对话轮次、诊断数量、交互时长和时间效率作为补充指标,把评估从静态终点分数推向过程级动态性能。对于依赖纵向疾病轨迹和持续状态更新的系统,时间切片尤为必要,因为它能防止信息泄露把”回顾性正确性”伪装成”实时协作能力”。
鲁棒性、运行效率
相比单个代理,医学多代理系统更容易出现链式脆弱性:一个错误的检索步骤、不恰当的路由决策或扭曲的中间摘要,可能会被继承、放大,并在下游节点固化为团队结论。因此,鲁棒性评估不应只关注端点错误率,还应该检查系统能否吸收错误、暴露冲突、追踪证据并回滚异常。
运营效率也应作为核心评估维度,因为 MAS 的部署价值取决于额外协作成本是否带来净收益。临床规模的工作量研究已经表明,准确率、延迟和 token 消耗必须一起报告;否则就不可能判断多智能体编排是否真正优于单智能体处理。
当前医学 MAS 用到的评测数据集和基准
当前对医学多智能体系统的评估主要围绕六类任务展开:
- 动态问询 / 渐进信息披露 → 测信息获取和交互组织能力
[98] - 住院路径 → 测多阶段角色转换下的稳定性
[104] - 纵向病程 → 测共享状态和早期预测能力
[63] - 安全评估框架 → 测不同拓扑下脆弱性和风险扩散
[112] - 成本敏感诊断 → 测运营成本与升级策略权衡
[118] - 多模态推理 → 测跨模态集成
[115]
Representative evaluation datasets and benchmarks for medical MAS(代表性数据集/基准清单)(这些数据集在论文里的用途为”评测基准”)
| 数据集/基准 | 数据来源与类型 | 主要任务场景 | 主要评估能力 | 常用指标 | 代表性文献 |
|---|---|---|---|---|---|
| JAMA Clinical Challenges(JAMA 临床挑战) | JAMA 临床挑战病例(从 1,519 例中筛出 815 例) | 动态诊断与渐进式信息披露 | 问询组织、信息获取、动态诊断收敛 | 准确率、对话轮数 | [98] |
| MIMIC 系列(MIMIC-III/IV) | 真实住院 EHR、ICU 数据和病程记录 | 住院路径、任务编排、实体抽取、因果分析、成本敏感诊断 | 工作流连续性、共享状态建模、运行效率 | 准确率、F1、AUC、token 使用量、延迟 | [7, 87, 104, 118] |
| PDSQI-9 + MIMIC-III/ProbSum | 医学文档摘要与质量评分量表 | 医学文本生成质量的自动评审 | 自动评审与专家的一致性、评审结果可靠性 | ICC、Krippendorff’s alpha、Gwet’s AC2 | [117] |
| VHA 纵向临床笔记(CARE-AD) | 美国退伍军人健康管理局(VHA)的长期病历与临床笔记 | 阿尔茨海默病早期预测 | 长期记忆、共享状态、时间切片预测 | 准确率、精确率、召回率、F1 | [63] |
| VUMC 真实医嘱集 | 范德堡大学医学中心的真实医嘱集与知识库 | 医嘱集优化与临床可执行性评估 | 输出可执行性、人机一致性、专家筛选 | 专家评分、Cohen’s kappa | [47] |
| 临床规模混合任务集 | PubMed 文献、EHR 出院小结和剂量计算任务 | 检索、抽取、计算的混合负载 | 稳定性、可扩展性、运行效率 | 准确率、延迟、token 成本 | [7] |
这些数据集把医学 MAS 评测从静态问答推向 process(过程)、time(时间/时序)、deployment(部署)三个维度。但任务定义不一致、过程标注不足、报告标准分散。应该统一报告 outcomes、路由日志、工具调用、证据链、分歧状态、资源消耗。
⭐六类分类只是现状描述,作者的落点是”需要一个最小报告框架让六类评测能横向比较”。final score 无法反推内部发生了什么,而医学 MAS 的增量价值恰恰在内部:路由决策对不对、工具调用是否规范、证据链完不完整、分歧是怎么消解的、协作花了多少资源都是无法通过单一MAS输出的,所以作者给出了统一的基准性清单
面临的挑战
| Xiong 2026 风险(具体机制/数字) | 草稿对应小节 |
|---|---|
| 5.1.1 级联误差放大(下游把上游错误当前提,经改写/总结/裁决固化;无反驳/纠正/升级机制时多轮讨论会把错误变成集体共识) | 3.6.1 虚假一致 + 3.6.2 上下文崩塌/过度自信 |
| 5.1.2 共识偏见(集中裁决受模型家族偏置、多数意见或使用僵化的静态协作工作流可能会把表面一致当高质量共识) | 3.6.1 虚假一致/沉默同意 |
| 5.1.3 记忆污染(共享状态被错误中间判断污染、长期病程线索丢失) | 3.6.2 上下文崩塌 + 3.6.3 隐私 |
| 5.2.1 隐私边界扩展(AgentLeak:MAS 总体隐私暴露约为单智能体的 1.6 倍;缓存/复制/复用) | 3.6.3 安全与隐私 |
| 5.2.2 问责结构复杂化(单智能体系统中的错误通常可以相对容易地追溯到模型、训练数据或部署实体。在多智能体系统 (MAS)中,一旦规划、检索、推理、验证和执行被分配到不同的角色,责任链条就会变长。为了解决这个问题,当前研究不再将责任仅仅视为事后归因, 而是试图将其嵌入系统设计中。) | 3.6.3 安全与隐私 |
| 5.2.3 偏见的链式放大(多智能体系统(MAS)并不比单一智能体更公平或更可靠。临床医生可能过度信任系统输出,未能及时识别错误、偏见或不完整证据。) | 3.6.1 + 3.6.3 |
| 5.3 监管/标准化缺失(无商业部署、无 FDA 批准/CE 标志、无前瞻上市后性能;分阶段部署:静默 → 监督 → 有界试点 → 审计 → 撤回标准) | 3.6.4 评测不足与报告 + 4.4 研究空白 + 4.2 成熟度 |
未来的方向(技术创新路径)
医学 MAS 的可靠推理既需要结构化知识约束,也需要可控的人机协作。知识图谱、循证关系(遵循证据做决策)和患者特定信息不应只是作为检索到的片段被被动输入,而应成为跨智能体共享的结构化支架,明确约束推理路径。因此,未来的医学 MAS 更可能演化为受知识约束、由人与 AI 共同治理的临床系统(人机协作的价值在于把人类判断放在高风险节点,而不是事后复核输出),而不是完全自主的封闭智能体集群。